Comment KIABI & USERADGENTS embarquent l'IA dans l'application KIABI ?


Qui n'a jamais fixé une étiquette de vêtement sans comprendre la moitié des pictogrammes ? Ces petits symboles normés existent pour aider à prendre soin de ses vêtements. Mais en pratique, ils restent peu précis, voire opaques pour certains utilisateurs. Chez KIABI, c'est un irritant identifié : les clients veulent prendre soin de leurs vêtements, mais les étiquettes ne leur parlent pas toujours. C'est de ce constat utilisateur qu'est né le scan d’étiquettes de lavage intelligent.
Cyrille, lead développeur iOS chez USERADGENTS, a mené le développement de cette fonctionnalité de bout en bout avec l’équipe iOS de KIABI. On vous raconte comment il a construit le scan d’étiquettes, depuis le choix technique jusqu’à l'implémentation, en passant par l'entraînement du modèle IA.
Sélection du bon outil IA pour le bon usage : pourquoi le cloud a été écarté
La réponse évidente à notre besoin aurait été d'appeler une API Cloud : envoyer une photo, recevoir une interprétation. Google Vision, GPT-4o, Rekognition d'AWS, les candidats ne manquent pas, et le câblage prendrait une demi-journée. Mais trois raisons nous ont conduit à rejeter cette approche.
La première concerne l’expérience utilisateur (UX). Un scanner d'étiquettes, ça doit fonctionner en temps réel : la caméra reconnaît les symboles au fur et à mesure qu'on les cadre, sans appuyer sur un bouton, sans attendre une réponse réseau. Avec une API Cloud, on parle de 2 à 3 secondes de latence. C'est acceptable pour une recherche, c'est rédhibitoire pour un scanner.
La seconde est d'ordre éthique et réglementaire. Envoyer des photos vers un serveur tiers, même pour une fonctionnalité aussi anodine qu'un scanner d'étiquettes, soulève des questions légitimes sur la vie privée. Et pour un retailer grand public, c'est un vrai sujet de gouvernance.
La troisième raison est écologique. Chaque appel à une API cloud mobilise des ressources serveur (calcul, refroidissement, transfert réseau) pour une requête qui, dans ce cas précis, peut parfaitement être traitée localement. À l'échelle de milliers d'utilisateurs qui scannent des étiquettes, l'empreinte carbone d'une approche cloud n'est pas anodine. Un modèle on-device ne génère aucun trafic réseau, s'exécute sur le Neural Engine de l'iPhone, conçu précisément pour ce type de charge, et consomme une fraction de l'énergie qu'impliquerait un aller-retour serveur.
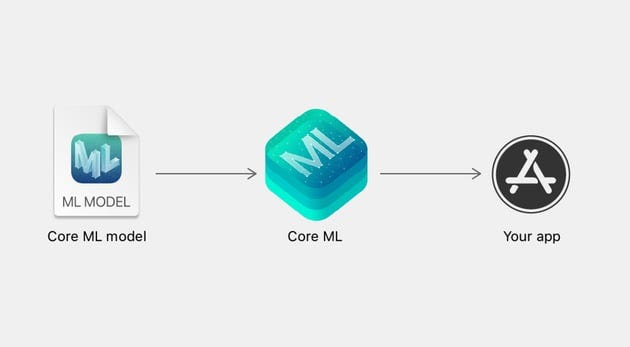
CoreML, le framework d'apprentissage automatique fondamental d'Apple, règle ces 3 problèmes. Le modèle tourne entièrement sur l'appareil, sans réseau, sans transfert de données, la reconnaissance est instantanée et aucune image ne quitte jamais le téléphone de l'utilisateur. L'entraînement est facilité par Create ML, l'outil Apple dédié, et le modèle peut être mis à jour à tout moment par simple téléchargement du modèle (et non de l'app), indépendamment des cycles de lavage de release de l'app.
Constitution du dataset : + de 400 photos et du bon sens
Un modèle de machine learning est aussi bon que les données sur lesquelles il est entraîné. Avant d'écrire une seule ligne de Swift, Cyrille a constitué un dataset à la main : plus de 400 photos d'étiquettes de lavage.
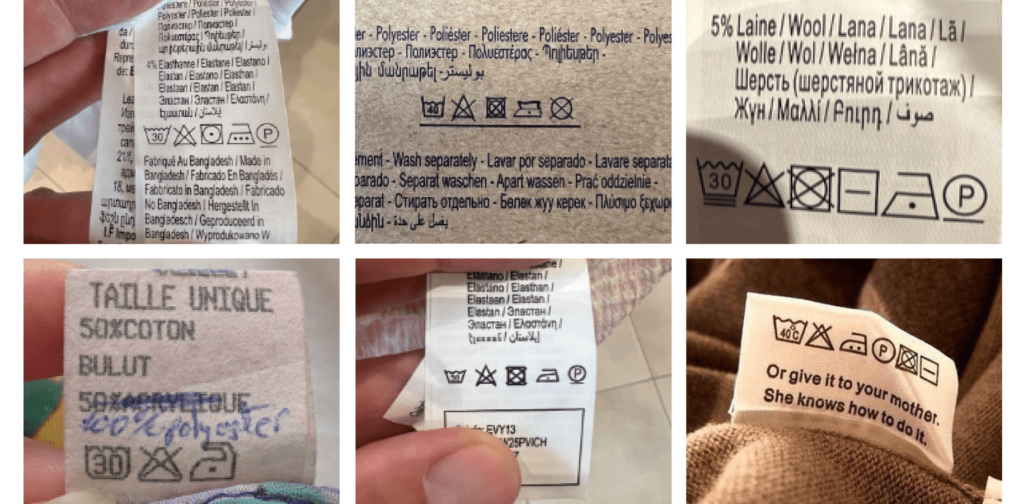
La collecte s'est faite sur deux terrains. En magasin d'abord : bonne luminosité, étiquettes neuves, photos propres et représentatives du catalogue KIABI. À domicile ensuite, sur des vêtements d’autres marques et usagés : étiquettes froissées, passées au lavage des dizaines de fois, parfois à peine lisibles. Cette dualité n'est pas anecdotique : un modèle entraîné uniquement sur des étiquettes neuves, parfaitement éclairées et à plat, aura du mal à reconnaître les symboles d'un pull porté trois hivers.
Ce travail terrain a aussi mis en évidence un angle mort que les normes ne résolvent pas : en pratique, chaque marque dessine ses pictogrammes à sa façon. Même forme de base, mais épaisseur de trait différente, proportions légèrement variées, rendu selon le type de marquage, imprimé sur une étiquette textile cousue ou directement brodé dans la matière. Le modèle a donc dû apprendre à reconnaître les symboles dans toute leur diversité réelle, pas dans leur version "idéale" extraite d'un document de norme.
Le seul point faible du dataset à ce stade : la sous-représentation des symboles plus rares comme le lavage délicat ou la soie. C'est un axe d'amélioration identifié pour les prochaines itérations du modèle.
Classification : annoter avec Roboflow, le travail de fourmi qui fait tout
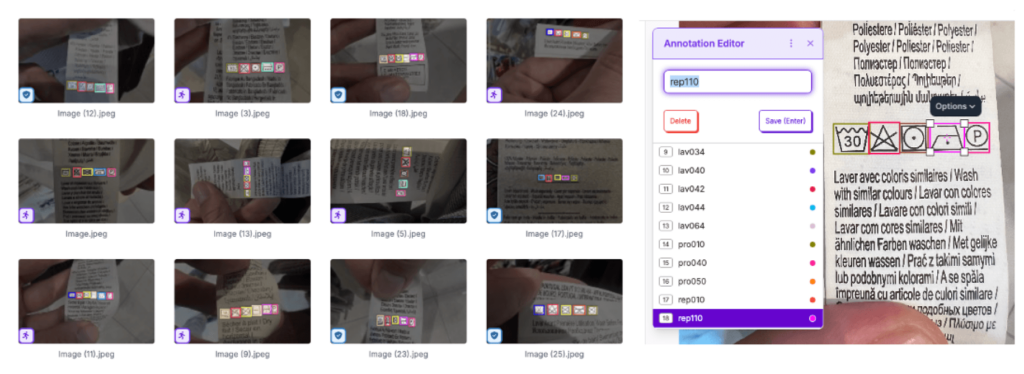
La phase la plus fastidieuse du projet, et probablement la plus déterminante. Récolter 400 photos, c'est bien. Les annoter correctement, c'est ce qui transforme un tas d'images en données d'entraînement exploitables. Cyrille a utilisé Roboflow pour cette étape : import des images sur la plateforme, puis, pour chacune, tracé manuel d'une bounding box autour de chaque pictogramme et attribution du code correspondant : lav030 pour "laver à 30°", rep110 pour "repassage à 110° max", bla010 pour "blanchiment interdit",... Photo par photo, symbole par symbole, sans raccourci.
Roboflow propose aussi ses propres capacités d'entraînement, mais nous n’avons utilisé que la partie annotation. L'entraînement reste dans l'écosystème Apple, via Create ML, pour maîtriser l'ensemble du pipeline et ne pas introduire de dépendance externe. Une fois le dataset annoté exporté, il est directement ingérable par Create ML.
L'entraînement : 8 heures sur M1 Pro, 30 Mo en sortie
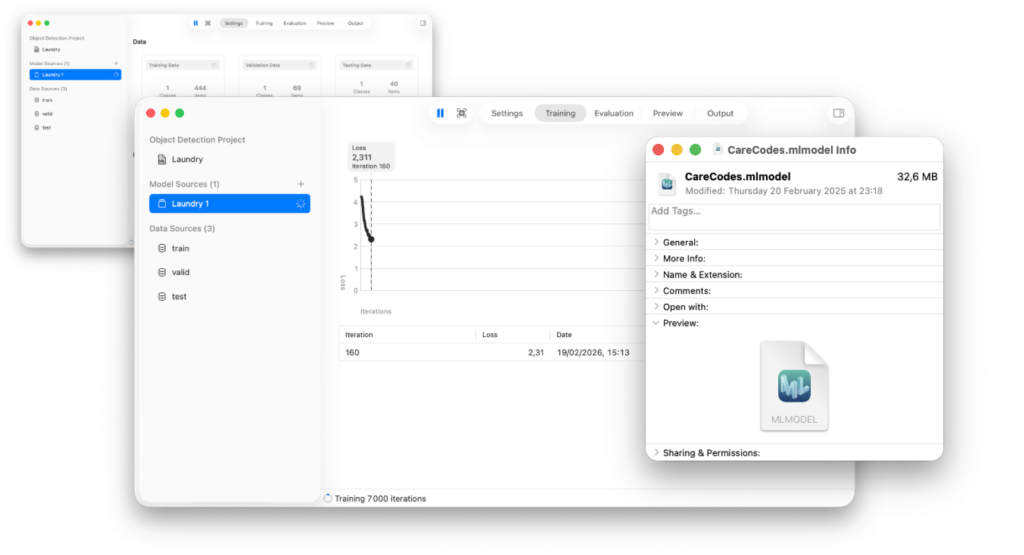
Dans Create ML, le projet est configuré en mode Object Detection : un choix important. Contrairement à la classification d'image simple (qui prédit une seule catégorie pour une image entière), l'Object Detection localise et identifie plusieurs objets simultanément dans une même photo. C'est exactement ce que l'on veut : une étiquette contient généralement 4 à 6 pictogrammes distincts, et on veut tous les reconnaître en un seul passage.
Sur un MacBook Pro M1 Pro 32 Go, l'entraînement a pris environ 8 heures pour 7 000 itérations. En sortie, un modèle CoreML compilé sous la forme d'un fichier binaire de 30 Mo : léger, autonome, prêt à être embarqué. Ce qui est appréciable avec Create ML, c'est la lisibilité du processus : la courbe de loss descend en temps réel, la précision sur le jeu de validation est monitorée en continu, on voit le modèle apprendre (pas de boîte noire).
L'implémentation iOS : 70 lignes de Swift
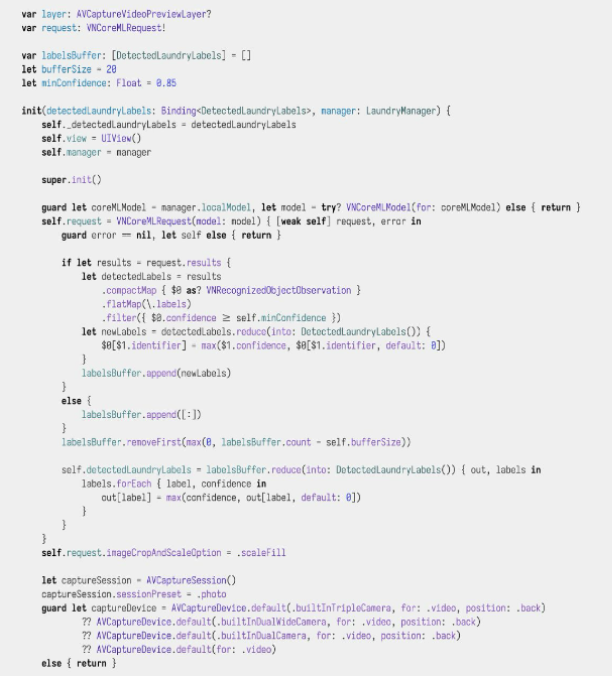
C'est la partie qui surprend le plus. Deux frameworks Apple suffisent à tout faire :
- AVKit pour capturer le flux vidéo en temps réel depuis la caméra
- Vision pour exploiter le modèle CoreML sur chaque frame capturée
Le pipeline en cinq étapes :
1. Une AVCaptureSession ouvre le flux caméra et l'affiche dans un AVCaptureVideoPreviewLayer
2. Un AVCaptureVideoDataOutput capture ce flux image par image
3. Chaque frame est envoyée à un VNImageRequest, le moteur de détection CoreML
4. Les résultats remontent sous forme de VNRecognizedObjectObservation, avec le label du symbole détecté et son score de confiance
5. Ces détections sont superposées en temps réel par-dessus le flux vidéo
Le tout en 70 lignes de Swift. Pour un scanner temps réel, embarqué, qui identifie plusieurs pictogrammes simultanément. C'est la puissance de l'écosystème Apple quand les couches d'abstraction sont bien conçues : l'implémentation devient presque triviale.
Le déploiement : modèle hébergé, app allégée, mises à jour silencieuses
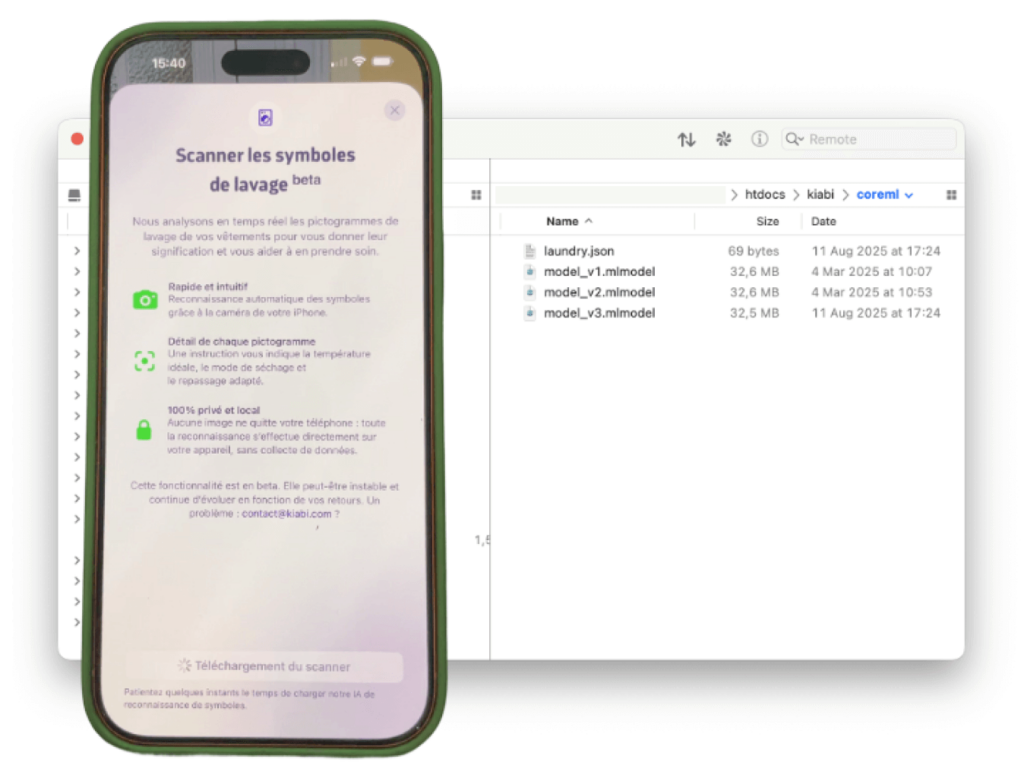
Inclure le fichier .mlmodel directement dans le bundle de l'app aurait ajouté 30 Mo au poids du téléchargement pour tous les utilisateurs, y compris ceux qui n'ouvriront jamais le scan, ce qui n’est pas très optimal.
La solution : le modèle est hébergé sur un serveur web et embarqué en arrière-plan à la première ouverture de l'onboarding du scanner. Pendant que l'utilisateur découvre la feature, le modèle se charge discrètement. Lors des utilisations suivantes, tout est déjà prêt.
L'avantage opérationnel est significatif : mettre à jour le modèle ne nécessite aucune soumission App Store. On pousse un nouveau fichier sur le serveur, les utilisateurs récupèrent la nouvelle version au prochain lancement de l’app, de manière transparente.
Le go-live : un déploiement progressif et contrôlé
Le module a été architecturé dès le début pour être totalement découplé du reste de l'application, sans aucune dépendance sur les autres équipes produit ou technique de KIABI.
L'activation en production s'est faite via un feature flag Firebase Remote Config, avec déploiement progressif : faible pourcentage d'utilisateurs d'abord, observation du comportement réel, puis ouverture graduelle. L'A/B testing natif de Firebase permet de mesurer et d'ajuster avant d'ouvrir en grand.
Une approche de l'IA utile et maîtrisée
Le scan d’étiquettes résout un irritant utilisateur réel par une approche maîtrisée et utile de l'IA, pensée pour créer de la valeur d'usage, en apportant une réponse technique choisie pour ses qualités pratiques (vitesse, vie privée, indépendance réseau), et une implémentation qui reste maîtrisable : 400 photos annotées à la main, 8 heures d'entraînement, 70 lignes de code, 30 Mo.
Pour les prochaines itérations du modèle, nous prévoyons un enrichissement du dataset sur les symboles rares et l’amélioration de la robustesse en conditions dégradées (mauvaise luminosité, étiquettes très abîmées).
La fonctionnalité (en beta) est disponible dans l'application iOS de KIABI.
Vous vous posez des questions sur la mise en place d'IA in-app ou d’agents pour vos services ? Contactez-nous !
Sur le même sujet

Étude : Pourquoi est-il urgent de refondre votre site en 2026 ?
6 questions pour décider s'il vous faut encore un design system à l’ère de l’IA
Flutter 3.47 : le framework largue pour de bon Material et Cupertino
UAPP Observer Assurance & Mutuelle : le mobile attend encore sa révolution
GenUI : et si on laissait la machine composer l’interface en temps réel ?

UAPP Observer Sport 2026 : le match se joue aussi dans l'app

UAPP Observer Mobilités 2026 : quand l'application devient le service

UAPP Observer Pilotage de la maison 2026 : du canal utilitaire au tableau de bord du foyer
Pourquoi choisir Firebase AI Logic pour intégrer l'IA dans une app Android ?
